/> VibeCoding 实战总结 从  写代码到驾驭 AI:研发方式的实战演进
查看源码 ↗ 阅读文章 ↗
元宇宙研发中心

VibeCoding 实战总结

从写代码到驾驭 AI:团队研发方式的实战演进

制作人
王欢
时间
2026年9月
面向
部门内部交流
键盘浏览 ←→切换章节 ↑↓切换章节内页面 右下角导航箭头有操作提示,也可点击切换页面
Table of Contents

章节目录

从认知建立到工程化协作,按 8 大章节逐步深入实战。

CHAPTER 01

VibeCoding 是什么?

建立认知框架:从“逐行写代码”到“表达意图与审查”

传统编码 vs VibeCoding 对比

传统编码范式

  • 核心载体: 键盘手动输入每一行代码 / 语法
  • 思维瓶颈: 根据 API 参数、框架规范与配置
  • 排错方式: 肉眼调试、查 StackOverflow / 文档
  • 角色定位: 编程人员(Programming)代码产出者
  • 交付速度: 受限于打字速度与检索记忆成本

VibeCoding 新范式

  • 核心载体: 自然语言 Prompt + 上下文工程驱动
  • 思维瓶颈: 需求拆解能力、架构设计与审查能力
  • 排错方式: 错误日志自动喂给 AI 快速迭代修复
  • 角色定位: 意图表达者 (Director) + 代码审查者 (Reviewer)
  • 交付速度: 意图理解即生成,效率提升数倍,甚至数十倍

一个任务,VibeCoding 怎么做?

以「新增批量导出 CSV 功能」为例,看完整闭环如何运转

01
表达意图
你来做
用自然语言写清楚需求、边界与约束,喂给 AI
→
02
AI 生成代码
AI 来做
模型读取上下文,自动生成实现、补充测试用例
→
03
审查 Diff
你来做
逐块 Review,关注架构合规、边界覆盖与安全风险
→
04
验收 / 迭代
协同
测试通过则合入;有问题直接反馈 AI,重新生成
真实 Prompt 示例(第 01 步)
在 tasks 模块新增批量导出 CSV 接口,支持 fields[] 参数过滤列,输出需含表头行;不影响现有分页查询接口;新增对应单元测试覆盖空列表与超大数据集边界场景。

开发者角色,发生了什么变化?

VibeCoding 不是"让 AI 替代你写代码",而是把你的能力杠杆化

传统开发者
Craftsman · 手工匠人
  • 专注语法 / API 细节记忆
  • 检索文档、StackOverflow
  • 手动追栈调试
  • 逐行键入实现细节
  • 速度受限于打字 / 记忆
VibeCoding
范式转变
→
意图表达者 + 审查验收者
Director & Reviewer
  • 拆解需求,构建清晰上下文
  • 把关架构合规与安全边界
  • 审查 Diff,验收测试结果
  • 将错误日志快速反馈给 AI
  • 速度取决于需求清晰度
编程能力不被削弱,而是被杠杆化——你的判断力,现在能驱动 10× 的代码产出

VibeCoding 三条核心理念

“用自然语言驱动代码生成,开发者转型为意图表达者与审查验收者。”

1. 意图高密度输出

精准的自然语言 Prompt 取代繁琐手写——业务目标、边界条件、约束逻辑一次性说清楚。

例:"支持字段过滤,输出含表头,不影响现有分页接口,补边界测试"

2. 上下文决定质量

相同任务:配置了规范文件(CLAUDE.md)的对话 vs 空白对话,生成质量差异显著。

项目结构 + 规则文件 + API 示例 = AI 的工作上下文

3. 闭环质量审查

AI 生成初稿,人把关验收——三步不省略:

Diff 逐块 Review
单测跑通
Lint / 类型检查通过
CORE DEFINITION

“你描述意图,AI 负责实现,你负责验收”

这是软件工程从“手工制造”迈向“自动化工业组装”的里程碑

CHAPTER 02

VibeCoding 发展历程

理解技术演进脉络:从代码补全到 MCP、Skills 与多 Agent 的工程化协作

VibeCoding 技术演进时间轴

21
2021年
GitHub Copilot 技术预览
AI 代码补全走向大众
22
2022年
ChatGPT 发布
对话式编程兴起
23
2023年
Cursor 0.2.0 发布
AI IDE 初步成熟
24
2024年
Claude 3 / GPT-4o 发布
多模态与 Agent 能力加速演进
25
2025年
Claude Code / Gemini CLI
CLI Agent 工具快速普及,VibeCoding 术语传播
26
2026年
MCP + Agent Skills 工程化落地
从调用工具走向可复用能力与治理

行业数据:AI 编码工具已从尝试走向日常

2023–2026 权威调查快照:每张卡代表不同的调查问题与样本口径

2023 · 美国
曾尝试使用率
92%
大型企业开发者曾在工作或个人时间使用 AI 编码工具
GitHub 调研|n=500
美国、1,000+ 员工企业
2024 · GitHub 企业调研
工作中试用率
97–100%
在工作中试用过 AI 编码工具的受访者比例
美国 99%巴西 100% 印度 99%德国 97%
每国 n=500|合计 n=2,000
2025 · 中国|整体与研发
企业高覆盖率
27.65%
受访研发企业已让 90%+ 开发者 使用智能开发工具
背景:截至 2025 年 12 月,中国网民生成式 AI 普及率为 42.8%
研发企业(中国信通院)+全国整体(CNNIC)
2026 · 全球
专业工具采用率
74%
开发者已在工作中采用专业 AI 开发工具
背景:90% 经常使用至少一种 AI 工具进行编码与开发
JetBrains AI Pulse|n>10,000
不可横向同比:92%、97–100%、27.65% 与 74% 分别衡量“试用”“企业覆盖”“专业工具采用”,不是一条年度趋势线。
阅读方式:这是“采用快照”,不是同口径同比曲线:2023/2024 为 GitHub 企业调研,2025 中国卡片分别为全国网民与研发企业口径,2026 为 JetBrains AI Pulse;样本、地区与提问方式均不同。
来源: GitHub 2023 Developer Survey | GitHub 2024 Developer Survey | CNNIC 第 57 次《中国互联网络发展状况统计报告》 | 中国信通院《AI4SE 行业现状调查报告(2026)》 | JetBrains AI Pulse(2026)

国内外主流大模型:能力、开放性与成本取舍

同一公开基准横评:分数为 Artificial Analysis Intelligence Index v4.1(越高越好),展示模型在标注的推理档位下的结果。

海外闭源前沿PROPRIETARY

Claude Opus 4.8 max · 复杂推理 / 编码
56
GPT-5.5 xhigh · 通用能力 / Agent
55
Gemini 3.1 Pro Preview · 长上下文 / 多模态
46

国内开权重主力OPEN WEIGHTS

GLM-5.2 reasoning · 私有化部署候选
51
Qwen3.5 397B A17B reasoning · 开权重生态
45
DeepSeek V4 Pro max · 高性价比推理
44
能力差正在收窄开权重头部 GLM-5.2 为 51 分,与可用闭源头部 Claude Opus 4.8 的 56 分相差 5 分。
成本差仍很显著同一指数任务的公开估算:DeepSeek V4 Pro 约 $0.04;GPT-5.5 约 $0.99;Claude Opus 4.8 约 $1.78。
选型不是只看分数追求极限复杂任务可优先评估海外闭源模型;数据域、成本和私有化约束强时,优先评估国内开权重模型。
口径与来源:Intelligence Index v4.1 汇总 9 项评测,推理档位、版本和成本会随供应商更新而变化,适合作为能力带状参考,不替代团队 POC。
Artificial Analysis Intelligence Index v4.1 | GLM-5.2 公开评测说明 | Qwen3.5 开权重评测说明 | OpenCode AI 数据榜单
CHAPTER 03

VibeCoding 环境安装与配置

零基础快速上手:打造你的 AI-Native 开发装备

主流 AI Coding 工具全景图

CLI Agent 类

Claude Code / Codex CLI

OpenCode CLI / Kimi Code CLI / CodeWhale

运行于终端的 Agent:文件读写、Git 操作、命令执行与自动化闭环。

AI 架构 IDE 类

Cursor / Windsurf / Trae

Qoder / CodeBuddy / Kimi Code

原生 AI 编辑器:代码库索引、规则文件、多文件并行编辑与 Agent 工作区。

IDE 插件 Plugin

GitHub Copilot / Cline

JetBrains AI / CodeBuddy Plugin

嵌入现有 IDE:行内补全、Chat、局部重构及第三方 Agent 接入。

客户端 Desktop

ChatGPT / Claude Desktop / OpenCode

AntiGravity / SOLO Coder / Eigent

独立桌面入口:多项目会话、任务队列、MCP 连接与可视化操作。

主流工具生态清单CLI · IDE · 插件 / Agent · Desktop
国际
Claude Code CLI Codex CLI / Web Gemini CLI CLI GitHub Copilot IDE / CLI Cursor AI IDE Windsurf AI IDE Cline VS Code Aider CLI JetBrains AI / Junie IDE Zed AI IDE
国内
Trae AI IDE Qoder CN IDE / 插件 CodeBuddy IDE / CLI Kimi Code CLI / VS Code 百度 Comate IDE 插件 CodeGeeX IDE 插件 Qwen Code CLI / IDE MarsCode AI IDE Comate 智能体 Desktop

工具类型划分与组合逻辑

先选工作界面,再选模型与权限边界:四种形态可以并存,不必把一款工具当成全部工作流。

CLI AgentTERMINAL FIRST

把自然语言直接接入终端、代码库和 Git,是自动化与复杂任务的主力入口。

Claude CodeCodex CLIGemini CLIAider
适合:批处理、脚本、代码审查、Git 工作流与无图形界面环境。

AI IDEPROJECT WORKSPACE

以项目工作区为核心,提供代码索引、规则文件、多文件编辑和可追踪的 Diff。

CursorWindsurfTraeQoder
适合:日常开发、跨文件重构、调试与长期项目协作。

IDE PluginKEEP YOUR IDE

保留团队既有 IDE 与快捷键习惯,在编码现场补齐 Chat、补全和局部 Agent 能力。

GitHub CopilotJetBrains AIClineComate
适合:存量 IDE 团队、轻量辅助、逐步引入 AI 的研发组织。

Desktop ClientVISUAL AGENT HUB

以独立会话与任务面板承接编码 Agent,并适合图文、文件与 MCP 的可视化操作。

Codex AppClaude DesktopCodeBuddyQoder
适合:方案讨论、多项目任务队列、非终端用户与可视化协作。
AI 客户端 / 调用端+LLM
本质上,四种工具只是交互界面与工作流不同。多数工具本身不生产模型,而是连接 Claude、GPT、Gemini、DeepSeek、GLM 等模型接口。有自研模型的厂商可一体化交付;没有自研模型的厂商,则把模型能力封装成更适合开发的工作台。

实操:四种工具形态如何开始

任选与你当前工作界面最接近的一种开始。关键不是安装得多,而是让工具真正读取项目、执行任务并产出可审查的变更。

CLI Agent终端直接驱动

  1. 1安装 Agentnpm i -g @anthropic-ai/claude-code
  2. 2进入项目根目录,运行 claude(复用 ~/.claude/settings.json 中的 DeepSeek / GLM 配置,无需 Anthropic 账号登录)。
  3. 3从一个可验证任务开始:读代码、改一个函数、运行测试。
首个成果提交一份可审查的 Git Diff 与测试结果。

AI IDE项目工作区主场

  1. 1安装 Cursor、Trae、Qoder 或同类 AI IDE,并登录账号。
  2. 2以项目根目录打开工作区,等待代码索引完成。
  3. 3写入项目规则,再用多文件任务生成并检查 Diff。
首个成果完成一次跨文件小重构,并逐块接受变更。

IDE Plugin不换 IDE 的入口

  1. 1在 VS Code / JetBrains 市场安装 Copilot、Cline、Comate 等插件。
  2. 2登录并设置模型或团队授权,打开现有代码仓。
  3. 3从当前文件选中一段代码,让 Agent 解释、补全或重构。
首个成果保留既有快捷键与调试习惯,完成局部改造。

Desktop Client可视化任务中枢

  1. 1安装 Codex App、Claude Desktop 或团队指定客户端并登录。
  2. 2创建项目会话;按产品能力授权文件夹、Git 或 MCP。
  3. 3用任务卡描述目标、验收标准与边界,再审查执行记录。
首个成果将需求、附件、执行过程和结果集中到一个会话。

你的代码与 Prompt,最终落在谁的服务器?

Claude Code 本身不生产模型:它把你的代码与 Prompt 转发给模型服务商。区别只在于“数据最终停留在谁的服务器上”。

默认情况(走 Anthropic 直连)

Anthropic 直连
你的代码 / Prompt 本地输入 · 待执行任务 Claude Code CLI 本机调用端 · 转发请求 Anthropic API 服务器 模型推理 · 数据最终停留处 api.anthropic.com ← 数据在这里 Claude 模型响应 推理结果返回本机 · 审查 Diff / 测试

配置第三方 API 后(不走 Anthropic)

国内 API
你的代码 / Prompt 本地输入 · 待执行任务 Claude Code CLI 本机调用端 · 转发请求 GLM / DeepSeek API 服务器 第三方模型推理 · 数据最终停留处 open.bigmodel.cn / api.deepseek.com ← 数据在这里 第三方模型响应 推理结果返回本机 · 审查 Diff / 测试
输入(本地) Claude Code CLI · 调用端 Anthropic API 服务器 GLM / DeepSeek API 服务器 模型响应 数据最终停留处
对团队意味着什么:无论走哪条链路,代码与 Prompt 都会离开本机、上传到模型服务商。选择“数据落点”,是合规与安全的第一道选择题。

国内推荐组合(二选一)

任选其一即可开工;两者共用同一份 ~/.claude/settings.json,先选工作界面,再配置模型接口。

方案一:Claude Code + DeepSeek / GLM APICLI 终端驱动 · 适合自动化与批处理

  1. 1安装 CLI:npm i -g @anthropic-ai/claude-code
  2. 2在 ~/.claude/settings.json 中配置共享环境变量(见下方配置块)。
  3. 3运行 claude,用 /model 切换 DeepSeek / GLM 模型。
  4. 4接 DeepSeek:ANTHROPIC_BASE_URL 改为 api.deepseek.com/anthropic,模型用 deepseek-chat。

方案二:VS Code + Claude Code 插件图形化面板 · 原生 Diff 审查

  1. 1扩展市场(Cmd/Ctrl+Shift+X)搜索 Claude Code 并安装(需 VS Code 1.94+)。
  2. 2复用同一份 ~/.claude/settings.json(已含 DeepSeek / GLM 的 ANTHROPIC_BASE_URL 与 ANTHROPIC_AUTH_TOKEN),无需再登录 Anthropic 账号。
  3. 3点击右上角 Spark 图标;若仍弹出登录提示,勾选 Disable Login Prompt 改走第三方 API 凭据。
  4. 4选中代码用 Option/Alt+K 插入 @-mention,在 Diff 视图逐条接受 / 拒绝改动。
统一验收看 Diff、跑测试、检查日志,再决定是否合并。
共享配置:~/.claude/settings.json(CLI 与 VS Code 插件通用)替换 YOUR_API_KEY 为你上一步获取的 API Key
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "YOUR_API_KEY",
    "ANTHROPIC_BASE_URL": "https://open.bigmodel.cn/api/anthropic",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.2[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.2[1m]",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1
  }
}

扩展插件 (MCP/Skills) 与标准工程结构

推荐 MCP / Skill / 插件

Chrome DevTools MCP MCP
捕获 Console 报错、Network 请求与 DOM 实时调试
GitHub
Context7 / CodeGraph MCP
生成项目全局 AST 函数依赖与架构上下文图谱
GitHub
Playwright / Computer Use Plugin
AI 操控真实浏览器完成端到端自动化与视觉回归测试
GitHub
Sequential Thinking MCP
强化 LLM 复杂算法推演、逐步思维链与自修正逻辑
GitHub
GitHub Server MCP MCP
自动检索 Commit 历史、分支管理、提交 PR 与处理 Issue
GitHub
Fetch / Doc Search Skill
实时抓取解析第三方最新官方技术文档与 API 规格说明
GitHub

交互式 VibeCoding 工程树结构

点击可展开/折叠各节点
  • my-vibecoding-project/ # 项目根目录
    • AGENTS.md # 根目录多 Agent 智能体协同全局规范与行为约束
    • CLAUDE.md # 根目录 Claude Code 顶层指令契约与项目全景知识库
    • .claude/ # Agent 核心配置与上下文根目录
      • settings.json # 环境变量、模型及执行权限边界定义
      • CLAUDE.md # Agent 长期记忆与团队高频指令指南
      • commands/ # 团队自定义 Slash 指令库
        • review.md # /review 代码审查与重构规范指令
      • skills/ # 领域技能包 (Reusable Skill Packs)
        • api-design/ # API 规范技能
          • SKILL.md # 提示词模板与响应规则说明
      • rules/ # 模块化细粒度规则 (Modular Rules)
        • 00-security.md # 密码学、SQL 注入等安全防护红线
        • 01-code-style.md # TypeScript/Rust 规范与风格约定
        • 02-architecture.md # 分层架构边界与依赖反转规范
    • .agents/ # Subagent & 多 Agent 协作流程配置
      • workflows.json # 多 Agent 协同工作流编排图
    • .cursor/ # Cursor IDE 专属规则映射
      • rules/*.mdc # Cursor 语境 Rule 文件
    • .mcp.json # Model Context Protocol 本地与远程服务绑定表
    • .claudeignore # 告之 Agent 屏蔽构建产物与依赖项,大幅节省 Token
    • docs/ # 架构设计、PRD、接口契约与调试文档
      • PRD.md # 产品需求文档、业务场景与 User Story 定义
      • architecture.md # 核心业务系统设计说明书与技术架构图
    • tests/ # 自动化单元测试与 E2E 回归套件
      • e2e/app.spec.ts # Playwright 端到端界面回归用例
    • src/ # 应用主业务源码目录
      • index.ts # 业务入口模块
扩展生态与技能市场推荐: ModelScope Skills 社区 腾讯云 SkillHub 市场 MCP Market 开发者工具

大模型选用策略:能力、成本与上下文

选对模型比选贵模型更重要。以下三个维度帮助你在实战中做出更合理的判断。

能力已达"高级工程师"水准
CAPABILITY THRESHOLD
  • ✓ 日常基础开发(增删改查、API 对接、单测编写)无需最顶尖模型,主流模型均可胜任
  • ✓ 国产大模型(GLM、Qwen、DeepSeek 等)在主流编码基准上已属行业前列,是合规优先团队的首选
  • ✓ 复杂架构决策、跨系统深度推理仍是顶尖闭源模型的差异点,但差距在快速收窄
建议:先用国产模型 POC,有明确差距再升级
参数大 ≠ 效果好
CONTEXT COLLAPSE STRATEGY
  • ! 不同模型有不同的上下文压缩(坍缩)策略,超出窗口后的截断方式直接影响输出质量
  • ! 我们自己管理上下文(Rules、Compact、精确文件注入)的方式同样关键——人的策略 > 模型参数
  • ! 后续章节将专题介绍上下文工程与 Harness Engineering,详见第 4 章
同一任务在不同模型 + 不同上下文策略下,结果可能相差悬殊
成本与收益多维权衡
COST · BENEFIT TRADEOFFS
上下文体积
投入 Token 数直接决定费用,精简无关内容
流程步数
Agent Loop 越长消耗越大,学会拆分任务
解决手段
截图比对、视觉验证等多模态输入会显著增加成本
过渡校验
中间结果人工确认可节省后续返工 Token
控制单次任务 Token 消耗 > 追求最强模型
实战心法:先用够用的模型跑通主流程,再识别瓶颈节点、按需升级。上下文工程与任务拆分对结果的影响,常常大于换一个更贵的模型。
CHAPTER 04

概念演进与实用方法

从 Prompt 工程到 Loop 工程:掌握顶级开发者心法

从 Prompt 到 Loop:AI 开发能力进阶四部曲

STAGE 1

Prompt Engineering

提示词工程: 精雕细琢单条提问的句式、语气与少样本示例。

STAGE 2

Context Engineering

上下文工程: 精准投喂项目文件、AST 依赖节点与接口约定。

STAGE 3

Harness Engineering

驾驭工程: 建立 Rules、权限防线、类型约束与自动测试栅栏。

STAGE 4

Loop Engineering

循环工程: AI 自主“编写-编译-测试-修正”的闭环自动化。

Prompt 黄金公式与正反实战对比

黄金公式: 1. 角色 (Role) + 2. 背景 (Context) + 3. 任务 (Task) + 4. 约束 (Constraint) + 5. 示例与格式 (Format)

Bad Prompt 示范 (模糊指令)

帮我写一个用户登录 API 接口。
后果: 框架随机选选、无密码哈希加密、无参数校验、冗余注释多,需反复修改。

Good Prompt 示范 (结构化指令)

【角色】Node.js 资深安全架构师
【背景】开发企业级 API 网关登录模块
【任务】实现 loginController 逻辑
【约束】必须用 argon2 密码哈希,参数校验用 Zod,禁用内联 try-catch
【格式】仅输出 Controller TS 代码片段
收益: 结果一发入魂,减少 90% 冗余交流,生成的代码直接达到生产部署标准。
核心使用技巧:让 AI 帮助生成与重构提示词 (Meta-Prompting) VibeCoding 提效杠杆
不必凭空构思 Prompt! 面对复杂需求时,先让 AI 扮演 Prompt 工程专家,为你反向定制最佳提示词模板。
📌 推荐反向提问模板: “我需要实现 [描述目标功能],请作为 Prompt 专家,基于黄金公式【角色+背景+任务+约束+示例+格式】,帮我撰写一份最适合投喂给你的完整 Prompt,并列出我需要补全的参数。”

提示词工程四大核心方法论

核心范式与方法论矩阵

1. CO-STAR 框架 结构化冠军范式
Context (背景) + Objective (目标) + Style (风格) + Tone (语气) + Audience (受众) + Response (输出格式)。
2. CoT 思维链 显式展示推理逻辑
关键词:“请先分析...再列出方向...最后给出代码”。复杂逻辑准确率大幅上升。
3. Few-Shot 示例驱动 示例胜过千言万语
提供 1~2 个真实 Input/Output 示例(如 Git Commit 格式/特定样式),锁定精确输出。
4. 角色扮演 (Role) 激活专家知识权重
设定专业身份:“你是有 10 年经验的 Node.js 性能架构师,请从性能与安全维度 Review”。

场景化模版与 PDCA 循环

场景化模版库 (Code Review / Debug)
# 代码 Review 类 Prompt 模板:
请从以下维度 review 代码:
□ 性能瓶颈与慢查询    □ OWASP Top10 安全漏洞
□ 边界条件与空指针    □ 是否符合 SOLID 原则
严重程度请用 🔴(高风险) 🟡(中风险) 🟢(建议) 标注。

# Debug 类 Prompt 模板:
报错信息:[完整 StackTrace] | 已排查:[尝试路径]
请先分析根本原因,再给出最少侵入的修复方案。

终极心法:Prompt 的本质是沟通设计

把写 Prompt 当作给一位聪明但对项目一无所知的新同事写工作说明:信息越结构化、越有边界,AI 输出就越稳定可用。

PDCA 迭代三步法: 基础版跑通 (Plan/Do) → 加约束收窄 (Check) → 加示例锁定风格 (Act)。

上下文工程:让 AI 始终“记得”你要什么

VibeCoding 最容易被忽视、却影响最大的核心技能,不是提示词写得多华丽,而是让真正重要的信息始终留在 AI 看得见的窗口里。

上下文窗口(Context Window)
┌──────────────────────────────────────┐
│ System Prompt                         │
│ + 历史对话 Round 1 ... Round N        │
│ + 当前文件 / 已加载的资料             │
│ + 你的新问题                          │
│                                      │
│ [████████████████████░░░░] 80% 已用 │
└──────────────────────────────────────┘
窗口满了 → 最早的信息先被压缩或遗忘
没有真正的“长期记忆”

模型每次回答,只能基于当前窗口中的内容推理。窗口内的信号越清楚,输出越稳定;无关历史、整文件粘贴和混杂任务越多,约束越容易被稀释。

上下文工程的本质:不是“塞得更多”,而是用有限窗口保存最高价值的信息。

窗口不是无限的:Token 是你的上下文预算

窗口级别模型(示例,已聚合)上下文预算感知
1M 级
1M~1.05M tokens
GPT-5.6 Sol(1.05M)
DeepSeek V4 Flash / Pro、GLM-5.2、Kimi K3、MiniMax M3、Claude Opus 4.8
容量充裕,但无关历史仍会稀释规则。
25 万级
256K tokens
Kimi K2.6长任务可用;应按模块保持会话聚焦。
20 万级
204.8K tokens
MiniMax M2.7仍需精选代码片段和稳定项目约定。

* 以上按当前课件口径聚合;模型版本与实际可用窗口以所用平台的实时说明为准。

Token ≠ 字数

  • 1 个汉字约消耗 1.5~2 tokens。
  • 代码符号、类型定义、长变量名的 token 密度通常更高。
  • 一个中等规模函数文件,轻松消耗 2000+ tokens。
预算思维:每粘贴一段内容,都要问——它是否能改变本次决策?

上下文污染的四种“死法”

01 对话过长导致遗忘

Round 1 约定 PostgreSQL,Round 20 生成 SQL 时却开始使用 MySQL 语法——早期约束已被挤出窗口。

02 代码把窗口撑爆

粘贴 1000 行文件 + 长对话 + 长回复,90% 预算被占用,真正的需求与安全约束最先被截断。

03 多任务混在同一会话

修登录 Bug、优化数据库、设计新 UI、再改登录——相关上下文被噪音淹没,前后矛盾概率上升。

04 隐式假设悄悄丢失

“所有接口必须 JWT 验证”若只在早期说过一次,几十轮后新接口可能漏掉认证,风险最难被及时发现。

共同根因:没有把稳定约束、当前任务和相关代码分层管理,导致“重要信息”与“聊天噪音”争夺同一个窗口。

两件最有效的事:永久规则 + 单任务会话

1. 把不变约定写入 AGENTS.md / CLAUDE.md

## 项目基本信息
- Next.js + TypeScript + PostgreSQL
- pnpm;禁止 npm / yarn
- Tailwind;禁止内联 style

## 安全规范
- API 路由必须验证 JWT
- 用户输入必须经过 zod 校验
- 日志禁止输出敏感信息

它们是项目“长期记忆”:每次会话都应最先进入上下文。

2. 单任务单会话

❌ 一个会话 = 整个项目的所有问题
✅ 会话 A = 登录功能
✅ 会话 B = 商品列表页
✅ 会话 C = 数据库性能优化

该开新会话时:任务完成、跨越模块、答案矛盾,或对话已超过约 20 轮。

会话开始要立边界,过程里要精准喂食

标准开场白模板

## 当前任务背景
电商后台;Next.js + PostgreSQL

## 本次任务
实现订单状态流转:待付款 → 已付款 → 已发货…

## 相关约束
- 变更必须记录操作日志
- 退款调用 /lib/payment.ts
- 所有操作需要管理员权限

## 现有代码
[仅粘贴相关函数、类型与接口签名]

精准喂食,不是整文件粘贴

❌ 整个 500 行 userController.ts

✅ 相关 30 行函数 + 类型定义 + 接口签名

// 其余 200 行是 CRUD,结构相同,此处省略

对话变长时主动压缩:“请用 200 字总结已确定的技术决策和约定,我将用它开启新会话。”

上下文管理的本质:信噪比管理

高质量上下文

项目约定(AGENTS.md) 20% ← 永远在
任务背景说明    20% ← 开场建立
相关代码片段    40% ← 精准投喂
当前问题      20% ← 清晰表达

低质量上下文

无关历史对话    40% ← 噪音
整个文件的无关代码 35% ← 噪音
真正需要的内容   25% ← 被淹没
核心心法:把 AI 当作一位每次上班都会失忆的超级程序员——工作手册是 AGENTS.md,开场白是今天的任务简报,精准代码片段是他需要的参考资料。

Rules:让 AI 长期按工程方式做事

Prompt 是临时任务简报

回答:写什么?
“实现订单状态流转”“修复登录 Bug”“为该页面增加筛选器”。

Rules 是长期工程宪法

回答:应该怎样写?
把架构约束、技术偏好、编码规范和禁止事项固化,让 Agent 无需每次被重复提醒。

读取:项目架构 → 技术栈 → 编码规范 → 禁止事项 → 当前业务约束  ↓  生成代码
System Prompt(系统人格) + Engineering Constitution(工程宪法)

最重要的 Rules 类别

① 技术栈
语言、框架、依赖与工具链
② 架构
模块边界、分层与依赖方向
③ 代码风格
命名、错误处理、测试要求
④ 数据库
表设计、迁移、查询与索引
⑤ 安全 认证鉴权、输入校验、敏感信息与日志边界
可按团队领域拆分 Rules
.ai-rules/
├── global.md          ├── java.md
├── architecture.md    ├── spring.md
├── database.md        ├── security.md
├── frontend.md        ├── android.md
└── business.md
持续改进闭环:AI 犯错 → 记录原因 → 增加 Rule → 以后自动避免 Prompt = 指挥员 Context = 情报 Rules = 制度 Model = 工程师

核心大脑:CLAUDE.md / AGENTS.md 最佳实践指南

为什么它们至关重要?

  • 项目宪法与长期记忆: 会话初始化时自动注入上下文,是 Agent 理解项目的最强基线。
  • 消除代码隐形偏差: 显式定义非标准的技术栈、独特设计模式与命名红线,杜绝幻觉。
  • 极致节省 Token 与交流成本: 避免重复给 AI 解释基础构建流程、单测指令和工程偏好。

撰写 3 大黄金法则

  1. 保持精炼 (Keep it concise): 只写 AI 无法自行从代码推断出的习惯与红线。
  2. 命令精确 (Specific Commands): 列出构建、测试和 Lint 的具体 Shell 命令。
  3. 动态演进 (Living Doc): 在踩坑和重构后及时更新,保持记忆最新。

CLAUDE.md 与 AGENTS.md 的关系

两者因提出时间与 Agent 生态发展阶段不同而存在命名差异。在核心功能、解析权重与写法上完全等效,可相互引用、相互继承,或配置为符号链接。

推荐标准模版结构 (通用)

# 项目核心指引 & 规范手册 (CLAUDE.md / AGENTS.md)

## 常用命令 (Commands)
- 构建项目: `npm run build`
- 运行单测: `npm run test:unit`
- 代码检查: `npm run lint`

## 代码风格 (Code Style)
- 使用 TypeScript 严格模式,禁止显式使用 `any`
- 组件命名使用 PascalCase,工具函数使用 camelCase
- 样式优先使用 Tailwind CSS 响应式类名

## 架构约束 (Architecture Rules)
- 业务逻辑必须封装于 `src/services/`
- API 返回值遵循 `{ code: number, data: T, msg: string }`

## 踩坑避坑红线 (DO NOTs)
- 严禁修改 `prisma/schema.prisma` 基础主键定义
- 提交代码前必须确保单元测试 100% 通过

Plan 模式:先让 AI 交方案,再让它动手

大型功能、重构或陌生代码库中,先进入 Plan / Ask 阶段:AI 只理解、分析与提出方案,不直接修改代码。确认方向后,再切换到执行模式。

Plan 阶段:先理解,不执行

  • 阅读相关代码、规则与现有实现
  • 识别影响范围、依赖、风险与未知项
  • 必要时提出澄清问题,不凭空假设
  • 输出可审阅的改动清单与验证方案

Execute 阶段:按批准方案落地

  • 逐项实施,变更范围不随意膨胀
  • 遇到新信息时说明偏差并重新确认
  • 运行计划中约定的测试、构建与检查
  • 交付变更摘要、验证结果与剩余风险
01 任务与约束 02 探索代码库 03 提出计划 04 人工确认 05 执行 + 验证

什么时候必须先 Plan?

适合:跨多个文件的功能、架构重构、数据库迁移、权限/安全变更、接手陌生模块。
不必:范围明确的文案、样式或单点修复——直接执行更快。

高质量 Plan 提示词

“先不要改代码。分析实现 ××× 所涉及的文件、现有模式和风险;给出分步计划、每步的验证方式,以及需要我确认的决策。”
Plan 的价值:把“AI 想到什么就改什么”变成“人机共同确认后再改什么”——成本最低的控制点,恰好在第一行代码写入之前。

常用 Slash 命令与 settings.json 权限控制

高频内置 Slash 命令指南

Slash 命令 核心功能与适用场景描述
/init 项目初始化: 扫描工程结构,自动创建 .claude/ 基础配置。
/plan 方案规划: 开启复杂任务模式,先输出设计步骤再动手编码。
/compact 上下文压缩: 压缩长对话历史,释放 60%+ Token 空间。
/review 代码审查: 对选定代码或 Diff 进行规范校验与安全重构。
/context 容量诊断: 实时查看当前会话 Token 占用与文件耗费分布。
/clear 会话重置: 彻底清除当前历史记忆,恢复至干净初始状态。
/model 模型切换: 动态切换底层模型(如 Haiku / Sonnet / GLM)。
小贴士: 终端输入 / 即可快速触发命令自动补全面板。

settings.json 权限安全体系

三级安全控制策略 (Allow / Ask / Deny)

  • allow (无感放行): 自动放行只读或安全单测指令。
  • ask (人类审判): 文件写操作与关键提交需手动二次确认。
  • deny (高危红线): 破坏性删除与敏感文件读取强行拦截。
{
  "permissions": {
    "allow": [
      "read:*",
      "exec:npm test",
      "exec:git status"
    ],
    "ask": [
      "write:*",
      "exec:git push*"
    ],
    "deny": [
      "exec:rm -rf *",
      "read:.env*"
    ]
  }
}
配置文件路径: macOS/Linux 为 ~/.claude/settings.json。

快捷符号体系与 Agent 终端交互指南

核心快捷符号体系

/ Slash 系统指令
触发 /plan 方案设计、/compact 压缩记忆与 /review 审计。
@ At 上下文精确定位
精准加载文件/代码行上下文(如 @src/user.ts#L10-L30),避开全库扫描。
! Bang 强制终端命令
强制要求 Agent 立即执行系统 Shell 指令(如 !npm test)并抓取终端日志。
& Async 后台进程启动
后台守护式运行常驻服务(如 &npm run dev),不阻塞当前交互。

终端快捷控制心法

Tab 键 路径与命令自动补全

输入路径或 / 时快速按 Tab 智能匹配补全目标。

Esc 键 思路偏离及时打断

当发现 Agent 思考死循环或方向偏离时迅速中断思维。

Shift + Enter 录入多行结构化 Prompt

方便换行分段,编写带角色、上下文与约束的黄金提示词。

Ctrl + C 终止前/后台运行进程

强制终止终端耗时死锁任务,释放本地系统 CPU 资源。

终端综合交互实操示范

CLI Agent 极速交互控制台
# 1. 使用 /plan 开启复杂任务规划模式
> /plan 依据 @src/types/auth.ts 重构登录 API

# 2. 强制要求 Agent 执行单测捕获 Traceback
> !npm test -- --grep "auth"

# 3. 后台守护运行 Dev 开发服务器
> &npm run dev

# 4. 实时诊断上下文占用与费用
> /context

# 5. 完成独立 Feature 后重置干净状态
> /clear
实战法则: 符号配合极速热键,可提升 3 倍以上的 CLI 交互效率!

Token 消耗防爆与成本控制指南

1. 模型选择与配置降本

  • 动态分层调度: 简单修改用轻模型(Haiku/GLM-4.7),复杂重构再用 Opus/GLM-5.2。
  • 设置窗口截断: settings.json 配置 CLAUDE_CODE_AUTO_COMPACT_WINDOW。
  • 禁用无用流量: 开启 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC。

2. 上下文工程精细化

  • 配置 .claudeignore: 屏蔽 node_modules、dist 及日志文件,防止全量扫描。
  • 及时 /compact 压缩: 内存占用 >70% 时执行 /compact 压缩历史记忆。
  • 单任务单会话: 完成独立任务后输入 /clear 恢复干净初始状态。

3. 拒绝无脑 @codebase

  • 避免滥用全量索引: 慎用 @codebase,防止一次性将整仓代码全量投喂。
  • 精准指定目标文件: 只 @ 修改涉及的具体文件或符号(如 @user.ts#L20-L50)。
  • 聚焦核心 Context: 用最精准的代码行支撑 Prompt 需求意图。

4. 按需加载,不滥用 Skill

  • 避免全局堆叠 Skill: Skill 初始化会占据上下文,避免根目录滥装大量全局技能包。
  • 保持 SKILL.md 精炼: 技能指导文档保持极致简练,只写 Step 与规则模板。
  • 隔离模块使用: 归类到特定子模块插件下按需隐式或显式召唤。

5. 配合 CodeGraph 裁剪 AST

  • 按函数节点精简: 借助 CodeGraph MCP 只引入关心的 Callers/Callees 函数链。
  • 切碎大文件依赖: 消除无关定义与大文件噪音,提升大模型理解准确度。
  • 结构化依赖分层: 以最小代价值传递精准上下文节点。

6. 实时监控与成本度量

  • 使用 /context 诊断: 养成长对话中输入 /context 查看占用和费用的习惯。
  • 设置 API 超时门限: 在 settings.json 设置 API_TIMEOUT_MS。
  • 单任务单目标: 专注单一任务,避免多目标发散造成 Token 浪费。

Vibe Coding 的不可能三角和五维模型

从单点工具能力,走向可持续放大的工程生产力系统

不可能三角

速度、质量、成本可以优化,但不能只依赖模型同时拉满。

交付速度 工程质量 人工成本
(人工干预、可控性)

只靠“换更强模型”往往只是把约束从一角,转移到另一角。

Vibe Coding 五维模型

每一维都决定 AI 能否稳定地产出可验证、可维护的工程结果。

有效工程量
/人工介入
模型能力理解与生成
上下文工程读对关键信息
Agent 工程分工与编排
软件工程约束与验证
人机协同判断与校准

最后真正要优化的是:单位人工介入下,AI 完成的有效工程量。

这已经不是单纯“哪个模型更聪明”的问题,而是 Context Engineering + Agent Engineering + Software Engineering 三者的交叉问题。一个反直觉的结论是:当模型上下文从 200K 发展到 1M,下一阶段的竞争点可能不再是谁能“塞更多 Token”,而是谁能“更少地读、但恰好读对”。这也是 Rules、Repo Map、Semantic Search、Sub-Agent、Context Compaction 越来越重要的原因。

展开阅读:不可能三角 展开阅读:五维模型

10 大 VibeCoding 实战黄金法则

1. 小步快跑,频繁 Commit: 生成可用片段即提交,方便快捷 Rollback。
2. 永远 Review 代码: 绝不盲目 Accept,警惕潜在逻辑 Bug。
3. 上下文越精准结果越好: 拒绝长篇大论,仅提供关心的代码行。
4. 主动管理 Memory 窗口: 定期使用 /compact 压缩无用对话。
5. 让 AI 写单测 ROI 最高: 用自动化测试帮 AI 验证生成的代码。
6. 复杂逻辑先画图: 先生成 Mermaid 图或伪代码,再转真实实现。
7. 保持批判怀疑: AI 会极其自信地犯错,必须验证断言。
8. 善用 Git Diff 视图: 逐行审查红绿变动,避免引入“附赠修改”。
9. 沉淀团队 Prompt 库: 优秀 Prompt 是团队重要的数字资产。
10. AI 是加速器而非替代品: 核心业务架构与安全仍由人类掌控。

常见踩坑案例分析 (Real Stories)

案例 1: 幻觉包注入

“引用了不存在的 npm 包”

事故: AI 自信地 import { cryptoTool } from 'express-secure-utils',该包系幻觉生成,黑客投毒后导致供应链安全隐患。

解法: 开启 Lint 检验并强制运行 npm install 检查源合法性。

案例 2: 上下文污染

“越改 Bug 越多陷入死循环”

事故: 带着 50 轮对话错误日志继续提问,AI 不断拆东墙补西墙。

解法: 及时 /clear 重置会话,重新梳理最精简上下文发问。

案例 3: 一步到位越界

“一口气重构整个项目”

事故: 要求“把整个项目从 JS 改为 TS”,导致修改了 80 个文件,无法通过 Review。

解法: 使用 /plan 拆解为 10 个独立子 Task 分批推进。

CHAPTER 05

项目实战经验

案例:长江电力新一代生产经营管理系统
项目原型体验地址: https://prototype.wanghuanlab.com
🚀 多人协作构建 600+ 页面超大型管理系统
大部分为产品组人员 相关研发人员仅 4 人(部分参与) 全栈工程师仅 1 人

非技术/产品团队 Git 工作流规范化

成员大多为非技术背景(产品组),通过自建 3 个自动化 Skill 封装底层复杂 Git 指令,实现全员高可靠协作
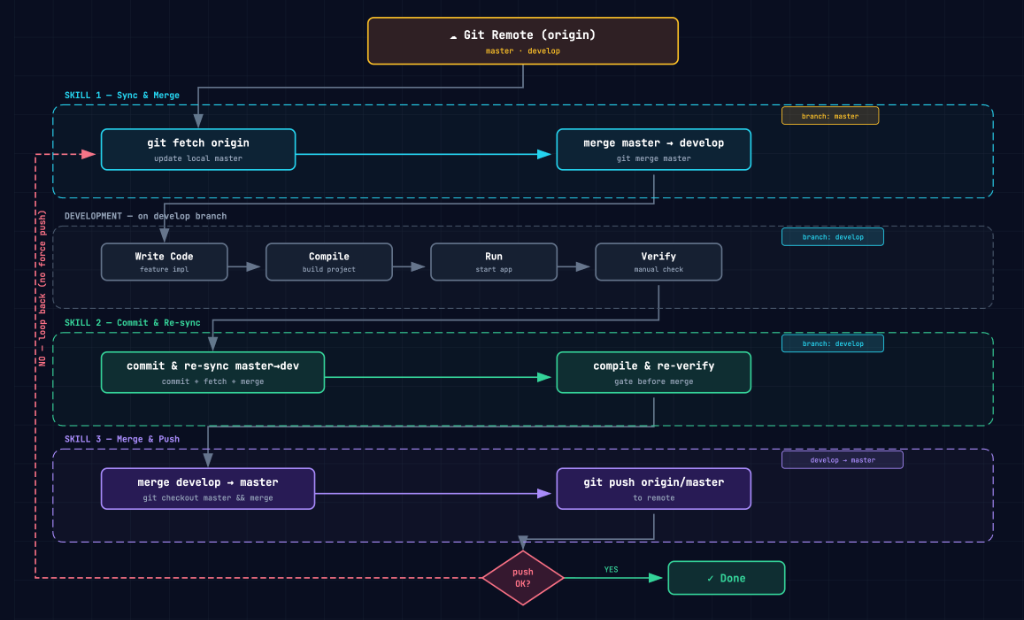
Git Workflow 3-Skill 架构图
点击架构图即可全屏放大查看高清细节
序号 阶段 Skill 名称 核心自动化用途 后续操作与异常处理
1 开发前 git-sync-master-to-develop 自动拉取更新 master 分支 → 合并到本地 develop 自检处理冲突后继续开发
2 开发后 git-commit-and-sync-master 提交 develop → 再次拉取 master → 反向合并到 develop 重新编译验证,有冲突自检处理
3 发布 git-merge-to-master-and-push 自动合并 develop 到 master → 推送至 origin/master 无异常继续从 Step 1 循环;有异常自检处理后从 Step 1 重跑

异构团队 600+ 页面风格统一:USP 治理体系 (MD + SKILLs)

12 位跨背景成员(含产品组)、4 种 AI 工具、多大模型混用下,基于开源项目 UI Style Pilot (USP) 实现组件代码和视觉规范统一

1. 工具异构

成员分别使用 Trae、VSCode、Qoder、CodeBuddy、IDEA 等不同编辑器/客户端。

2. 模型异构

后台混用 DeepSeek、GLM、QianWen、Minimax 等不同厂商模型。

3. 表达/ Prompt 异构

非技术产品人员与开发者的自然语言描述习惯差异巨大,极易导致样式脱节。

核心一 MD 规则资产库 (静态约束打底)

  • 配置文件标准化: 项目提交统一的 CLAUDE.md / AGENTS.md / .cursorrules。
  • 组件索引强制引入: 维护 src/components/index.ts,AI 生成前必须优先检索复用既有 UI 组件。
  • 设计 Token 硬性规定: 锁定 CSS 变量色盘、Spacing 与 Page Shell 响应式布局骨架。

核心二 SKILLs 技能自动化 (作业流程归一)

  • 作业指令标准化: 封装 page-building、design-review、component-reuse 等团队技能包。
  • 消弭自然语言表达差异: 成员只需唤醒特定 Skill,底层精准标准 Prompt 上下文自动填充锚定。
  • 工具/模型双重无关性 (Agnostic): 代码仓库自建治理规范,脱离特定 SaaS 工具依赖。

项目级 AI 生成规范:长江电力 AGENTS.md 实践拆解

团队统一制定 AGENTS.md / CLAUDE.md 作为 Agent 长期生效基线,约束 12 异构团队构建 600+ 页面 100% 规范一致

规则 1 Skill 路由与源码事实优先级

  • 5 大 Skill 强制路由: 页面构建、原型设计、组件复用、样式迁移与设计审查均需调用对应 Skill。
  • 源码事实优先级 (Fact Order): 组件状态表 > index.ts 导出 > Vue 源码 > Design Tokens > 业务页面 > 文档。

规则 2 技术选型与 Ds* 组件基线

  • 技术栈归一: 统一为 Vue 3 + TS + Vite + Ant Design Vue,严禁无故混用 Element Plus。
  • 标准组件库强绑定: 列表强制使用 DsPage/DsDataTable,表单使用 DsFormGrid,状态标签使用 DsStatusTag。

规则 3 红线禁令与“业务守恒”硬要求

  • 严禁自造轮子: 严禁内联 style、硬编码非 Token 颜色/圆角,严禁覆盖全局 .ant-* 类名。
  • 业务守恒 (Preservation): 迁移重构必须 100% 保留查询字段、权限按钮与数据契约,严禁凭空幻觉删减。
AGENTS.md 实战落地方案(支持 CLI / AI IDEA / IDEA Plugin / AI Desktop 自动感知):
# AGENTS.md 项目入口基线
- 任务与 Skill 路由映射:新增 Vue 页面必须调用 `frontend-page-builder` Skill
- 绝不重复造轮子:公共组件必须从 `@/components` 导入并使用 stable 状态组件 (`DsPage`, `DsFormGrid`)
- 业务守恒:重构必须完整保留页面按钮、字段条件、页签抽屉、接口契约与权限校验

长江电力 600 个页面系统:VibeCoding 研发质效量化对比

基于长江电力新一代生产经营管理系统实战(12 人团队,相关技术开发人员只4人,全栈仅1人,交付 600+ 页面与复杂业务流),传统模式与 VibeCoding 体系的实际量化对比

研发阶段与任务模块 传统开发估算 (600页) VibeCoding 实战耗时 提效幅度与成果
基础框架与 600+ 页面 Page Shell 铺设 20 人天 (脚手架/路由/菜单) 1.5 人天 (生成 前后端项目架构 骨架) 13.3x 提效
后台RBAC管理体系,视觉规范标准落地 15 人天 (基于甲方规范要求和开源项目) 2 人天 (DS*组件封装) 7.5x 提效
页面和业务流程开发 590 人天 (手动搭建 AntD Vue) 170 人天 (借助不同AI Agent) 3.5x 提效
样式迁移、UI 规范审查与 BUG 调试 25 人天 (人工逐页对比 CSS) 2.5 人天 (设计审查 Skill) 10x 提效
整体周期:650 人天 → 176 人天

总体研发周期压缩 73%,实现 3.7 倍级生产力跃迁。

88.3% 业务页面公共组件覆盖率

在 AGENTS.md 约束下,1,156 个业务视图中有 1,021 个深度绑定 Ds* 规范库 (调用超 1.9 万次)。

产品组独立交付 300+ 页面

非技术产品人员配合 3 大 Git Skill 独立写码并成功上线,打破技术壁垒。

关键范式变革收益:从“需求”直接生成“代码级页面” (Code-Native)

摒弃传统“先用 Axure 绘制低效原型、再由前端二次重复敲代码”的繁琐流程。在 VibeCoding 范式下,由需求直接生成高保真、可交互的代码级真实页面,变相实现了巨大的人力与时间资源再节省!

CHAPTER 06

VibeCoding 未来展望

范式变革:从工具演化到 AI-Native 开发范式重构

范式重构:研发流程的提效与闭环

传统研发流程 (串行/瀑布/敏捷)

需求分析 (PRD) UI/UX 设计 前端/后端开发 QA 联调测试 运维上线

AI 时代:高协同极简闭环

自然语言 Prompt 意图 Agent 直接生成 + 自动单测 人类最终 Review
UI2Code 提效

截图/Figma 直接转生产代码,压缩设计到开发边界。

PRD2Code 提效

需求文档输入 Agent 自动构建模块原型。

Bug2Fix 提效

监控日志直连 AI 自动提交 PR 修复补丁。

范式变革带来的机遇与挑战

评估维度 巨大的机遇 (Opportunities) 严峻的挑战 (Challenges)
研发效率 交付速度获得 3-10 倍量级提升 质量把控门槛与 Code Review 压力剧增
工程师角色 全栈门槛大幅降低,一人即为一个团队(OPT) 传统编程语言精通者的专业深度价值重估
架构控制 快速验证 MVP 产品原型与市场契合度 AI 容易生成隐性技术债务 (Technical Debt)
团队组织 小团队能做大产品,沟通摩擦大幅减少 团队代码规范与安全审计体系亟待新建

AI 普及壁垒与技术演进展望

壁垒 1 算力与硬件成本居高不下

部署顶级 AI 推理集群(如 H100 / GB200)硬件采购与电力成本极高。高并发模式下,大规模 Tokens 消耗的边际成本依然是企业全面普及的显著经济门槛。

壁垒 2 顶尖模型能力受限与闭源高门槛

目前真正具备深度逻辑推理与代码生成能力的 SOTA 级模型(如 Claude / GPT)依赖少数头部巨头闭源提供,存在网络延时、访问限制与数据合规隐虑。

历史必然规律:从昂贵奢侈品到水和电般的基础设施

正如电话、大中型计算机与 PC 刚诞生时一样: 早期技术必然伴随着昂贵与少数人特权。随着芯片算力效率提升、端侧/开源模型(如 DeepSeek 等)算法突破以及推理成本指数级下降,AI 必将突破这两大壁垒,如电网与 PC 般无处不在,真正开启全员 AI-Native 的全民普惠时代!

敏捷迭代与流程坍缩

1. 模型迭代指数加速

大模型演进迅猛:从前年的以年为单位更新,到去年的半年大版本更新,未来更新周期可能压缩至3 个月甚至更短。

2. 工作流程步骤坍缩

模型能力提升导致研发步骤被动坍缩:原本需要 7 步完成的工作,模型升级后只需 5 步,有 2 步被大模型直接接管内化。

3. 难以形成死板工作流

GitHub 上几乎每天都在诞生全新的万星 Skill 与 Plugin,工具链的高速阵痛重构导致难以形成固定的“标准 SOP 流程”。

“唯有不断学习与快速适应 —— 祝碳基生物好运!” 🚀

在技术海啸面前,不要试图固化教条;保持拥抱变化的心态,才是 VibeCoding 时代的终极生存法则。

CHAPTER 07

AI 安全性与隐私保护

合规使用:防范数据泄露,建立清醒的安全意识与操作规范

绝对红线:严禁上传与暴露的 4 大敏感内容

1. 敏感凭证类
  • API_KEY / AWS_SECRET
  • DB_PASSWORD / 数据库串
  • JWT_SECRET / 私钥 .pem
2. 用户隐私数据 (PII)
  • 真实姓名、手机号、身份证
  • 用户行为日志 (含真实 ID)
  • 医疗、金融、生产环境 DB Dump
3. 核心商业机密
  • 未发布产品的核心专利算法
  • 竞争壁垒相关的业务逻辑
  • 内部合同、财务、法律敏感文件
4. 基础设施配置
  • 服务器真实内网 IP / 拓扑图
  • 安全防火墙策略配置
  • 未修复漏洞扫描报告
核心安全心态 (Mindset):

把 AI 当作一位“能力极强但不了解你公司保密规定的外包同事” —— 你绝不会把数据库密码直接告诉他,但可以让他帮你写通用逻辑。把握好这个边界感,就是 AI 安全使用的本质。

开发人员实战规范:隔离、脱敏与代码自检

代码脱敏提问与 .env 隔离

// ❌ 危险:直接粘贴真实配置
const config = { dbHost: "192.168.1.100", dbPassword: "Prod@2026!", apiKey: "sk-abc123" }

// ✅ 安全:先脱敏为占位符再提问
const config = { dbHost: "DB_HOST", dbPassword: "DB_PASSWORD", apiKey: "API_KEY" }
.gitignore 与 .cursorignore 配置隔离:
.env  .env.local  *.key  *.pem  secrets/  private/

安全自检 Check 点与审查 Prompt

  • SQL 注入: 严禁字符串拼接 SQL,强制使用参数化 Bind。
  • XSS & 越权: 用户输入转义校验;每个接口强制鉴权检查。
  • 硬编码密钥: 坚决杜绝在生成的代码中死写配置。
实用 Prompt:让 AI 进行代码安全自检
请对以下代码进行安全审查,重点检查:SQL注入、XSS、越权、敏感泄露。
用 🔴高危 🟡中危 🟢低危 标注每个问题并给出修复方案:[粘贴代码]

供应链安全审查与合规 AI 工具选型矩阵

供应链安全:AI 新增第三方依赖审计 (npm audit / pip-audit)

AI 生成代码可能引入过时、废弃或幻觉伪造的恶意 npm/pip 包。每次新增依赖后必须跑命令扫描并核查 Star/下载量:

npm audit (Node.js) pip-audit (Python) trivy fs . (容器/文件扫描)
AI 工具名称 用于模型训练 企业隔离认证 数据存储协议 推荐应用场景
Cursor Business 可一键关闭 (Opt-out) 支持 SOC2 不持久化 (ZDR) 企业商业开发
GitHub Copilot Ent 可一键关闭 (Opt-out) 企业独立实例 加密传输不存盘 企业商业开发
Cursor 免费/个人版 默认可能开启 无独立隔离 有云端缓存 仅限个人学习/开源
Ollama 本地模型 完全无传输 物理级断网隔离 100% 纯本地 绝密/高敏感商业项目

团队级安全策略建设与 Code Review 检查清单

团队 AI 使用许可/禁止场景策略

✅ 允许使用场景:
  • 开源/公开技术学习;脱敏后代码逻辑讨论
  • 通用工具函数与 UI 组件生成;Mock 单元测试
❌ 严格禁止场景:
  • 包含真实用户 PII 数据的代码与 DB Dump
  • 核心加密/鉴权算法;含内网 IP 地址的配置文件

AI 生成代码 Review Checklist

🛡️ 安全性: □ 无硬编码密钥 □ 输入过滤完整 □ SQL/命令注入防护到位 □ 权限校验正确
📦 依赖安全: □ 新增依赖已通过 audit 扫描 □ 依赖版本已锁定 (package-lock)
🔒 数据合规: □ 未引入真实用户数据逻辑变更 □ 日志脱敏符合规范
CHAPTER 08

总结与问答

Let's Go:拥抱 AI-Native 时代,开启高效工作流

VibeCoding 时代工程师的核心竞争力

1. 架构理解与问题拆解力

从“代码撰写者”转变为“系统设计者”。能否把模糊业务需求清晰拆解为可被 AI 执行的具体规则与模块接口,决定了交付上限。

2. 严苛 Review 与鉴别品味

AI 负责生成海量代码,人类工程师负责最关键的鉴别、安全审查与边界断言。识别潜在逻辑漏洞与幻觉的能力成为核心壁垒。

3. 上下文工程与规则构建力

懂得如何精细化管理 Context,建立标准化团队规则(如 USP / CLAUDE.md),将领域知识与风格沉淀为可复用的数字资产。

Q & A

提问与交流环节

感谢观看!

拥抱 VibeCoding,开启智能开发新时代

制作人:王欢
2026 年 8 月